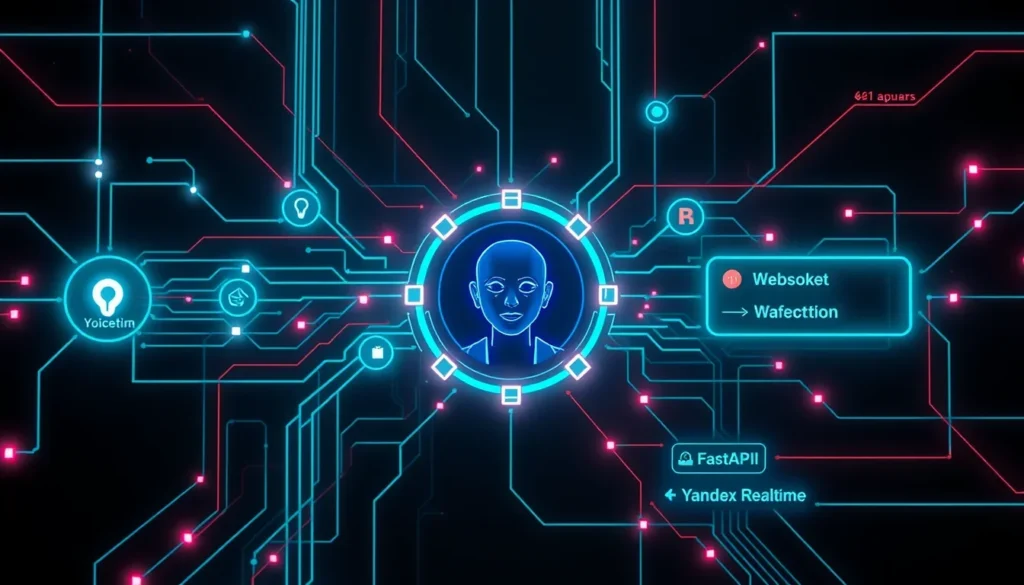
将 AI-头像 集成到现有的语音 AI 助手 Aika 中,不仅仅是添加一张脸,而是一系列技术挑战。我们力求在 Yandex Realtime 上保持当前的架构,以便新服务仅 根据已生成的声音进行唇部动画。在测试 Simli 和 Anam 的过程中,我们发现了回答前的停顿、iPhone 上的视频启动以及移动互联网稳定性方面的问题。在创建第二个角色 Eva 时,我们发现 神经网络 的可信度不仅取决于面部本身,还取决于上下文。
我们的语音引擎已经运行,因此任务仅限于面部动画。Aika 通过 WebSocket 直接在浏览器中与网站访问者通信,WebSocket 连接到我们基于 FastAPI 的服务器,该服务器又与 Yandex Realtime 保持会话。这提供了“语音到语音”模式,无需单独的识别链、文本模型和合成。
服务器以 24 kHz 的 PCM16 格式将未压缩的声音分块 (pcm_chunk) 传输到浏览器,并且需要根据此流同步头像的表情。
AI-头像平台选择:Simli vs Anam
两个经过测试的服务——Simli 和 Anam——都提供了一种模式,用户提供他们的音频流,服务生成带有与声音同步的动画面部的视频,并通过 WebRTC 返回媒体。因此,Yandex 继续生成语音,而头像服务负责视觉部分。
声音集成技术方面
- 采样率:Yandex 以 24 kHz 输出声音。Simli 需要 16 kHz,Anam 也设置为 16 kHz,尽管它支持其他格式。
- 音频块处理:声音以块的形式到达。为了避免连接处的伪影,小数位置和最后一个样本会传输到下一个块。这确保了动画的流畅性,尽管没有完整滤波器的频率重计算质量仍需改进。
安全和会话管理
服务密钥不会进入浏览器。页面通过 POST /voice/avatar-session 向我们的服务器请求一个短时会话令牌。服务器检查 origin 并限制令牌的颁发:每小时每个 IP 6 个,总共每小时 30 个。
如果未获取令牌或视频未启动,页面将切换到普通语音模式。令牌请求时间为 8 秒,SDK 启动时间为 15 秒。重要的是,SDK 成功启动并不能保证立即出现第一帧;面部在这里是补充,而不是关键功能。
Anam 中的头像状态管理
Anam 提供两个关键命令:
endSequence(): 在发送完话语的最后一个音频片段后调用。interruptPersona(): 在打断时停止头像当前的讲话,之后也会调用endSequence()。
Simli(旧一代)与 Anam Cara-4 的比较
我们比较了我们可用的版本:上一代的 Simli 和 Anam Cara-4。这不是对所有功能的详尽比较,而是针对特定任务的选择。
| 参数 | Simli(上一代) | Anam Cara-4 |
|---|---|---|
| 面部表情 | 嘴唇会动,其他面部表情有限 | 眨眼、微笑、露出牙齿、倾斜头部 |
| 面部创建 | 通过上一代 API 从照片创建 | 从一张照片创建,可提供试用视频 |
主观上,Anam 展现出更生动自然的表情。这对我们来说是决定性因素。接下来,我们遇到了一些特定的问题。
媒体播放特性
- 声音: 在 Simli 中,声音通过单独的音频元素播放;在 Anam 中,通过相同的视频元素播放。这意味着 Anam 的视频元素不能保持
muted,否则头像会“无声”说话。 - 分辨率: 视频通常以低分辨率(384×576)开始,几秒钟后才切换到高分辨率(768×1152)。选项
sessionOptions.videoQuality: "high"有帮助,但不能保证以高质量开始。 - 帧生成延迟: Anam 需要接收 0.8 秒的音频才能开始生成帧。这并不总是等于实际的 0.8 秒等待时间,因为声音可能比播放速度更快。
麦克风和会话管理
- 回声抑制: 在手机上,当 Ayka 说话时,麦克风会关闭,以避免从扬声器捕捉到她的声音。在 PC 上,麦克风处于活动状态,当用户开始说话时(来自 Yandex Realtime 的
barge_in事件),头像会停止当前的讲话。 - 会话槽占用: 在免费套餐中,只允许一个并发会话。如果浏览器崩溃,槽可能会保持占用状态。请求
GET /v1/sessions/concurrency有助于诊断槽的占用情况。 - 取消连接: 如果用户在视频连接期间点击“停止”,则需要正确终止异步操作,以免留下不必要的会话。为此,引入了生成计数器
videoGen。
iPhone Safari 上的问题
在 iPhone 上的 Safari 中,视频无法启动。假设这与自动播放规则有关。在视频元素上预先调用 play(),并临时提供来自 canvas 的流并取消 muted,在测试运行中有所帮助,但不是一个通用的解决方案。
优化响应前暂停
当虚拟形象沉默地看着用户时,长时间的响应前暂停比没有暂停感觉更糟糕。最初,静音阈值(VAD)设置为2.2秒,以防止Aika打断在停顿中口述信息的用户。
我们将电话桥的逻辑移植到网站:在正常对话中,阈值为1500毫秒,在口述时为2200毫秒。这允许动态调整VAD的灵敏度。设置通过session.update应用,无需重新连接。
创建第二个角色:Eva
对于工作室管理员Eva,我们遇到了空背景下的“库存金发女郎”问题。转折点出现在背景中出现了室内装饰:温暖的灯光、书架、植物、模糊的远景。这使得形象更具说服力,将“目录”变成了“工作中的人”。
背景和肖像创建的细节
- 背景:我们使用了符合我们风格的现有室内装饰,并使用生成器移除了人物。
- 人物抠图:Eva使用macOS Vision工具(
VNGeneratePersonSegmentationRequest,级别为.accurate)进行抠图。我们收缩并柔化了蒙版边缘,以消除光晕。 - 比例:保持背景中物体的比例很重要,以避免滑稽的情况(例如,身后巨大的杯子)。背景只取桌面以上的部分,并为肖像镜头进行模糊处理。
- 分辨率:对于Cara-4,建议使用1152×1152或更大的方形源图像。Real-ESRGAN ×4的纯放大使得皮肤过于光滑。神经网络放大与常规缩放、锐化和添加颗粒的组合效果更好。
Eva的配音
我们为Eva选择了Yandex LiveTTS系列中的一个声音。在SpeechKit API v3中,通过"model": "livetts"选择模型,并通过hints传递声音和角色。对于长文本,文本被分解成句子并单独合成。
从七个短语配音选项中,我们选择了vera声音,角色为casual。我们不得不重写短语,因为合成在重音方面一直出错。
录制带有虚拟形象的视频
Eva的视频是通过与实时通话相同的动画引擎录制的,使用MediaRecorder直接从video.srcObject(视频和音频一起,WebM与VP9和Opus)录制。为了正确启动录制,流会预先“唤醒”一秒钟的静音,以防止视频以黑屏开始。
常见问题
什么是AI虚拟形象,它是如何工作的?
AI虚拟形象是一种数字角色,能够根据提供的音频动画化面部表情和嘴唇动作。它使用神经网络创建逼真的视觉形象,与语音同步,使互动更自然、更具吸引力。
可以使用自己的声音用于AI虚拟形象吗?
是的,大多数平台,如Anam和Simli,允许您使用自己的语音引擎或预先录制好的音频。虚拟形象会根据此音频流来动画化面部,从而保持您的品牌或个人形象的辨识度。
集成AI虚拟形象的主要难点是什么?
主要难点包括音视频同步、音频块处理、延迟优化、确保在各种设备(尤其是移动设备)上的稳定运行,以及创建与上下文和品牌相符的令人信服的视觉形象。
背景如何影响AI虚拟形象的感知?
背景在创建令人信服的形象方面起着关键作用。空白或不合适的背景可能会使虚拟形象显得不自然。与角色或品牌风格相符的室内背景可以显著提高虚拟形象的真实性和可信度,营造出“人在工作”的感觉。
创建AI虚拟形象需要多少费用?
创建AI虚拟形象的成本可能因所选平台、定制程度、面部表情细节以及独特功能的需求而差异很大。有些服务提供订阅模式,而另一些则可能按每分钟生成的视频或独特角色的开发收费。
结论
集成AI虚拟形象是提高用户参与度的强大工具,但需要深入的技术开发。从平台选择到背景和停顿的精细调整,每一步都会影响最终结果。我们看到,神经网络能够为语音界面注入新的活力,但前提是必须关注细节。
如果您想扩展您的内容并为广告创建AI视频,请考虑订阅式神经制作的可能性。这可以生成数百个视频,无论是用于加密项目的AI UGC还是用于电子商务的AI视频工厂。我们随时准备为您提供帮助!联系我们,了解AI内容制作如何改变您的业务。