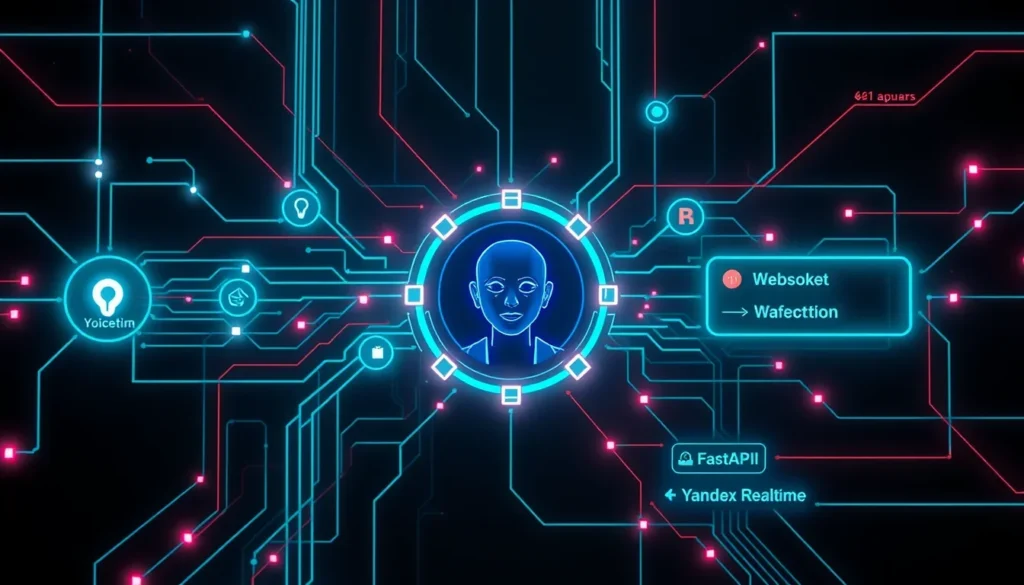
La integración de un avatar de IA en el asistente de voz de IA existente, Aika, no es solo la adición de una cara, sino una serie de desafíos técnicos. Nos esforzamos por mantener la arquitectura actual en Yandex Realtime para que el nuevo servicio solo animara los labios con el sonido ya generado. Durante las pruebas de Simli y Anam, surgieron matices con las pausas antes de la respuesta, el inicio del video en iPhone y la estabilidad del internet móvil. Y al crear el segundo personaje, Eva, se hizo evidente que la credibilidad de la red neuronal depende no solo de la cara en sí, sino también del contexto.
Nuestro motor de voz ya estaba funcionando, por lo que la tarea consistía exclusivamente en la animación facial. Aika se comunica con los visitantes del sitio directamente en el navegador a través de WebSocket, que está conectado a nuestro servidor en FastAPI, y este, a su vez, mantiene una sesión con Yandex Realtime. Esto proporciona un modo de «voz a voz», eliminando la necesidad de cadenas separadas de reconocimiento, modelo de texto y síntesis.
El servidor transmite al navegador sonido sin comprimir en formato PCM16 a 24 kHz en partes (pcm_chunk), y era necesario sincronizar la mímica del avatar con este flujo.
Elección de plataforma para el avatar de IA: Simli vs Anam
Ambos servicios probados, Simli y Anam, ofrecen un modo en el que el usuario proporciona su flujo de audio, y el servicio genera un video con una cara animada, sincronizada con el sonido, devolviendo el medio a través de WebRTC. De esta manera, Yandex continúa generando el habla, y el servicio de avatar se encarga del componente visual.
Aspectos técnicos de la integración de sonido
- Frecuencia de muestreo: Yandex emite sonido a 24 kHz. Simli requiere 16 kHz, Anam también se configuró a 16 kHz, aunque admite otros formatos.
- Procesamiento de fragmentos de audio: El sonido llega en fragmentos. Para evitar artefactos en las uniones, la posición fraccionaria y la última muestra se transfieren al siguiente fragmento. Esto asegura una animación fluida, aunque la calidad del recálculo de la frecuencia sin un filtro completo aún requiere mejoras.
Seguridad y gestión de sesiones
La clave del servicio no llega al navegador. La página solicita a nuestro servidor un token de sesión de corta duración a través de POST /voice/avatar-session. El servidor verifica el origin y restringe la emisión de tokens: 6 por hora por IP y 30 por hora en total.
Si no se obtiene el token o el video no se inicia, la página cambia al modo de voz normal. Se asignan 8 segundos para la solicitud del token y 15 para el inicio del SDK. Es importante destacar que un inicio exitoso del SDK no garantiza la aparición inmediata del primer fotograma; la cara aquí es un complemento, no una función crítica.
Gestión del estado del avatar en Anam
Anam proporciona dos comandos clave:
endSequence(): se llama después de enviar el último fragmento de audio de la réplica.interruptPersona(): detiene el habla actual del avatar cuando es interrumpido, después de lo cual también se llama aendSequence().
Comparación de Simli (generación anterior) y Anam Cara-4
Comparamos las versiones disponibles para nosotros: Simli de la generación anterior y Anam Cara-4. Esta no es una comparación exhaustiva de todas las características, sino una selección para una tarea específica.
| Parámetro | Simli (generación anterior) | Anam Cara-4 |
|---|---|---|
| Mímica | Los labios se mueven, el resto de la mímica es limitada | Parpadea, sonríe, se ven los dientes, inclina la cabeza |
| Creación de rostro | A partir de una foto a través de la API de la generación anterior | A partir de una foto, video de prueba disponible |
Subjetivamente, Anam mostró una mímica más viva y natural. Para nosotros, este fue un factor decisivo. Luego nos encontramos con una serie de problemas específicos.
Características de la reproducción multimedia
- Sonido: En Simli, el sonido se reproducía a través de un elemento de audio separado; en Anam, a través del mismo elemento de video. Esto significa que el elemento de video de Anam no se puede dejar
muted, de lo contrario, el avatar «hablará» en silencio. - Resolución: El video a menudo comenzaba con una resolución baja (384×576) y solo después de unos segundos cambiaba a alta (768×1152). La opción
sessionOptions.videoQuality: "high"ayudó, pero no garantizó el inicio con alta calidad. - Retraso en la generación de fotogramas: Anam necesita recibir 0.8 segundos de audio antes de comenzar a generar fotogramas. Esto no siempre equivale a 0.8 segundos de espera en tiempo real, ya que el sonido puede llegar más rápido de lo que se reproduce.
Control de micrófono y sesiones
- Supresión de eco: En el teléfono, mientras Aika habla, el micrófono se desactiva para evitar capturar su voz del altavoz. En la PC, el micrófono está activo, y cuando el usuario comienza a hablar (evento
barge_inde Yandex Realtime), el avatar detiene su habla actual. - Ranura de sesión ocupada: En el plan gratuito, solo está disponible una sesión simultánea. Si el navegador se caía, la ranura podía permanecer ocupada. La solicitud
GET /v1/sessions/concurrencyayuda a diagnosticar la ocupación de las ranuras. - Cancelación de conexión: Si el usuario hace clic en «detener» durante la conexión de video, es necesario finalizar correctamente las operaciones asincrónicas para no dejar una sesión innecesaria. Para esto, se introdujo un contador de generaciones
videoGen.
Problemas con Safari en iPhone
En iPhone en Safari, el video no se iniciaba. La hipótesis está relacionada con las reglas de reproducción automática. Una llamada preliminar a play() en el elemento de video con una alimentación temporal del flujo desde canvas y la eliminación de muted ayudó en la prueba, pero no es una solución universal.
Una pausa larga antes de la respuesta del avatar, que mira en silencio al usuario, se siente mucho más pesada que sin ella. Inicialmente, el umbral de silencio (VAD) se estableció en 2.2 segundos para que Aika no interrumpiera a los usuarios que dictaban información con pausas.
Trasladamos la lógica del puente telefónico al sitio web: en una conversación normal, el umbral es de 1500 ms, al dictar, de 2200 ms. Esto permite ajustar dinámicamente la sensibilidad del VAD. La configuración se aplica a través de session.update sin reconexión.
Creación de un segundo personaje: Eva
Para la administradora del estudio, Eva, nos enfrentamos al problema de una “rubia de stock” sobre un fondo vacío. El punto de inflexión llegó cuando apareció un interior detrás de ella: lámparas cálidas, estanterías, plantas, un fondo borroso. Esto hizo que la imagen fuera mucho más convincente, transformando el “catálogo” en una “persona en su lugar de trabajo”.
Detalles de la creación del fondo y el retrato
- Fondo: Utilizamos un interior ya hecho con nuestra estética, eliminando a las personas con un generador.
- Recorte del personaje: A Eva la recortamos con las herramientas de macOS Vision (
VNGeneratePersonSegmentationRequestcon nivel.accurate). El borde de la máscara se redujo y suavizó para eliminar el halo. - Escala: Es importante mantener la escala de los objetos en el fondo para evitar situaciones cómicas (por ejemplo, una taza gigante detrás). El fondo se tomó solo por encima de la encimera y se difuminó para un objetivo de retrato.
- Resolución: Para Cara-4, se recomienda una fuente cuadrada de 1152×1152. Un aumento puro de Real-ESRGAN ×4 hacía que la piel fuera demasiado suave. Una combinación de aumento por red neuronal con escalado normal, mejora de la nitidez y adición de grano se veía mejor.
Voz de Eva
Para Eva, elegimos una voz de la familia LiveTTS de Yandex. En SpeechKit API v3, el modelo se selecciona a través de "model": "livetts", y la voz y el rol se pasan a través de hints. Para textos largos, el texto se dividió en oraciones y se sintetizó por separado.
De siete opciones de voz para una frase, elegimos la voz vera en el rol casual. Tuvimos que reescribir la frase, ya que la síntesis se equivocaba constantemente con la acentuación.
Grabación de videos con el avatar
El video de Eva se grabó con el mismo motor de animación que una llamada en vivo, utilizando MediaRecorder directamente desde video.srcObject (video y audio juntos, WebM con VP9 y Opus). Para un inicio de grabación correcto, el flujo se “despertó” previamente con un segundo de silencio, para que el video no comenzara con una pantalla negra.
Preguntas frecuentes
¿Qué es un avatar de IA y cómo funciona?
Un avatar de IA es un personaje digital capaz de animar expresiones faciales y movimientos labiales de acuerdo con el audio proporcionado. Utiliza redes neuronales para crear una imagen visual realista que se sincroniza con el habla, haciendo la interacción más natural y atractiva.
¿Se puede usar la propia voz para un avatar de IA?
Sí, la mayoría de las plataformas, como Anam y Simli, permiten usar su propio motor de voz o audio pregrabado. El avatar animará la cara con este flujo de audio, manteniendo el reconocimiento de su marca o persona.
¿Cuáles son las principales dificultades al integrar un avatar de IA?
Las principales dificultades incluyen la sincronización de audio y video, el procesamiento de fragmentos de audio, la optimización de la latencia, la garantía de un rendimiento estable en varios dispositivos (especialmente móviles) y la creación de una imagen visual convincente que se ajuste al contexto y la marca.
¿Cómo influye el fondo en la percepción de un avatar de IA?
El fondo juega un papel fundamental en la creación de una imagen convincente. Un fondo vacío o inapropiado puede hacer que el avatar parezca antinatural. Un interior que coincida con el estilo del personaje o la marca aumenta significativamente el realismo y la confianza en el avatar, creando la sensación de la presencia de una «persona en el lugar de trabajo».
¿Cuánto cuesta crear un avatar de IA?
El costo de crear un avatar de IA puede variar mucho según la plataforma elegida, el nivel de personalización, el detalle de las expresiones faciales y la necesidad de funciones únicas. Algunos servicios ofrecen modelos de suscripción, mientras que otros pueden cobrar por cada minuto de video generado o por el desarrollo de un personaje único.
Conclusión
La integración de un avatar de IA es una herramienta poderosa para aumentar la participación del usuario, pero requiere una profunda elaboración técnica. Desde la elección de la plataforma hasta el ajuste fino de los fondos y las pausas, cada paso afecta el resultado final. Hemos visto que las redes neuronales son capaces de dar nueva vida a las interfaces de voz, pero solo con una cuidadosa atención a los detalles.
Si desea escalar su contenido y crear videos de IA para publicidad, considere las posibilidades de la producción de IA por suscripción. Esto le permite generar cientos de videos, ya sea UGC de IA para un proyecto de criptomonedas o una fábrica de videos de IA para comercio electrónico. ¡Estamos listos para ayudarlo con esto! Contáctenos para saber cómo la producción de contenido de IA puede transformar su negocio.